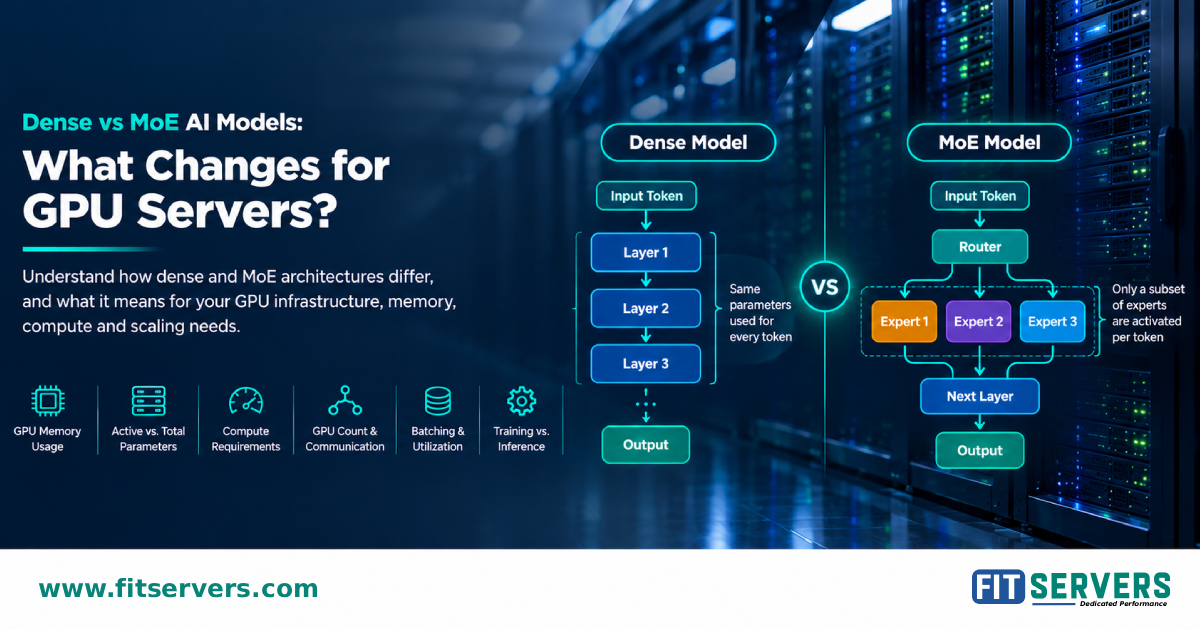
Dense vs. MoE AI Models: What Changes for Your GPU Server?
Large language models are no longer defined only by parameter count. Architecture decides how much compute each token needs and how weights are spread across GPUs.
Dense vs. MoE
Dense models use essentially the same parameters for every token.
MoE models use a router to activate only a few experts per token.
Example: DeepSeek-V3
671B total parameters, 37B activated per token. Neither “37B model” nor “dense 671B” describes it correctly.
Key Takeaways
MoE saves compute per token, but usually not VRAM for weights.
Expert parallelism spreads experts across GPUs.
Fast GPU-to-GPU interconnects reduce communication bottlenecks.
Quantization (FP16 → INT8 → INT4) can reduce weight memory by up to 4x.
Plan with four numbers: total parameters, active parameters, precision, and runtime memory.
Read More
Full guide with diagrams, comparison table, and FAQ: https://www.fitservers.com/blogs/dense-vs-moe-ai-models-gpu-servers/