파이썬 자료 구조, 상황에 따라 어떻게 고를까?
자료 구조 선택, 기준은 생각보다 단순해요
자료 구조 시리즈도 여기까지 왔네요. 리스트부터 튜플, 딕셔너리, 세트까지 하나씩 살펴봤는데요. 막상 코드를 쓰다 보면 이런 순간이 옵니다. “음… 이거 리스트로 할까, 딕셔너리로 할까?”
정답은 데이터가 어떻게 쓰일지에 달려 있어요. 순서가 필요한지, 이름표를 붙여 찾을지, 중복을 허용할지, 값을 바꿀 수 있어야 하는지부터 생각하면 선택이 쉬워집니다.
이번 글에서는 네 가지 자료 구조를 실제 상황에 맞춰 골라 볼게요. 지난 글에서 다룬 특징을 한 번에 정리하고, 다음 편에서 배울 함수로 이어지는 작은 예시도 만들어 보겠습니다.
순서대로 모으려면 리스트, 바뀌지 않으면 튜플
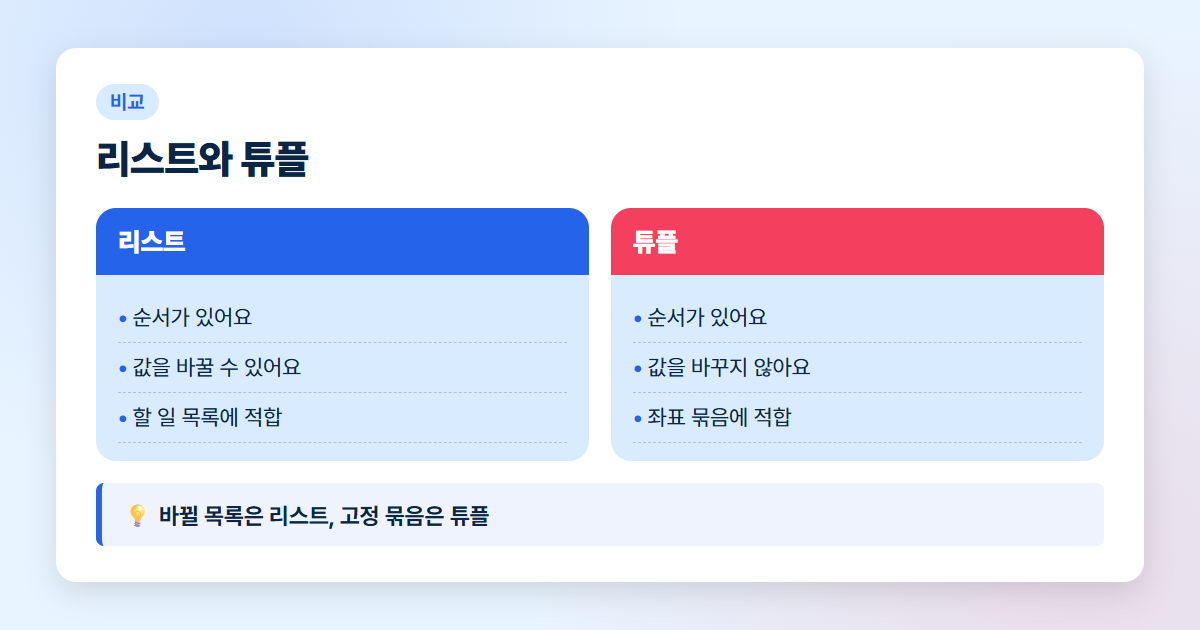
리스트는 순서가 있는 데이터를 모으고, 나중에 내용을 더하거나 바꿀 때 편합니다. 오늘 할 일 목록처럼 항목의 순서가 중요하고, 할 일이 추가될 수 있다면 리스트가 자연스러워요.
tasks = ["메일 확인", "회의 준비"]
tasks.append("코드 리뷰")
반대로 튜플은 만든 뒤 바꿀 필요가 없는 값들을 묶기에 알맞습니다. 좌표처럼 한 묶음으로 다루고 싶은 값이나, 변경하지 않기로 한 설정을 담을 수 있어요. “리스트보다 튜플이 무조건 낫다”는 뜻은 아닙니다. 바뀔 데이터라면 리스트가 더 편하죠.
한 가지 더 기억해 둘 점! 리스트와 튜플은 위치로 값을 찾습니다. 여러 항목을 순서대로 꺼내거나 반복해서 살펴볼 때 잘 맞아요.
이름표로 빠르게 찾고 싶다면 딕셔너리
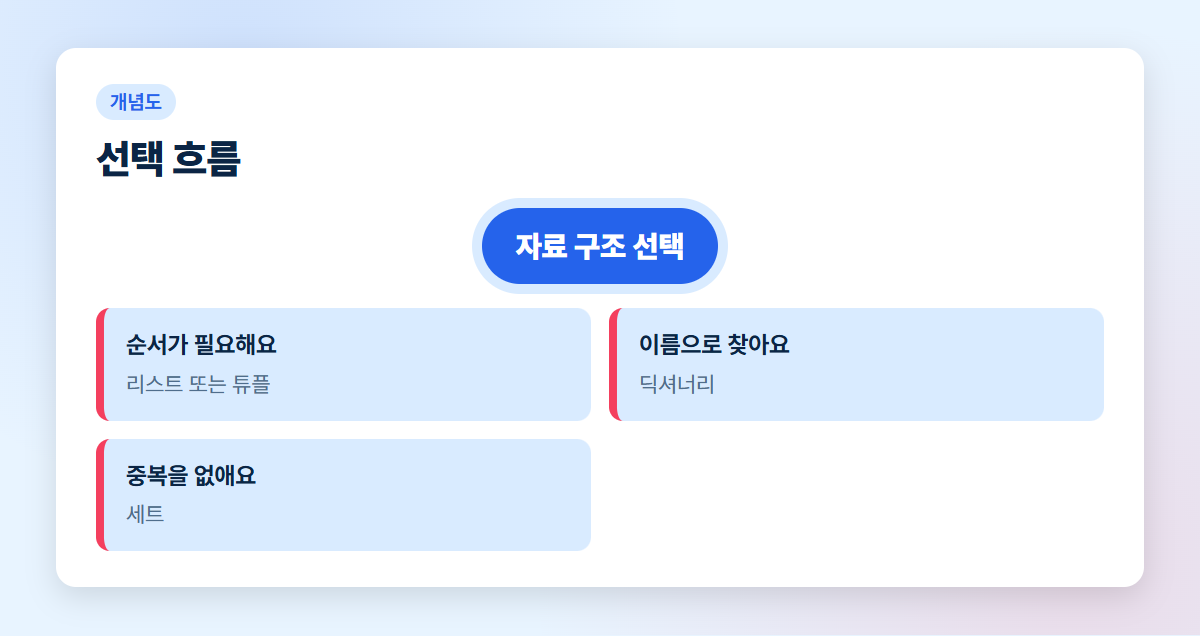
데이터에 이름표를 붙여서 찾고 싶다면 딕셔너리를 떠올려 보세요. 사용자 프로필처럼 이름과 이메일, 가입 연도를 연결하거나 상품 정보처럼 상품명과 가격을 짝지을 때 쓸 수 있습니다.
product = {
    "name": "머그컵",
    "price": 12000,
    "in_stock": True,
}
print(product["price"])
product["price"]처럼 키를 이용해 값을 찾으니, 몇 번째에 있더라 하고 세지 않아도 됩니다. 딕셔너리는 키가 겹치면 같은 키에 값 하나만 대응한다는 점도 기억해 두세요. 목록의 각 항목에 번호를 붙이는 대신, 의미 있는 키로 관리하고 싶을 때 특히 편합니다.
다만 키로 쓸 수 있는 값에는 조건이 있어요. 숫자나 문자열처럼 바뀌지 않는 값을 주로 사용합니다. 리스트를 키로 쓰려고 하면 오류가 나요. 저도 처음엔 “이름표로 쓰면 되겠지?” 했다가 파이썬에게 바로 제지당했습니다. 어?, 꽤 단호하더라고요.
중복을 빼고 싶다면 세트
중복을 없애거나 어떤 값이 포함되어 있는지 확인하고 싶을 때는 세트가 잘 맞습니다. 예를 들어 방문한 페이지 주소에서 고유한 주소만 뽑거나, 참가자 이름 중 중복 입력을 정리할 때 쓸 수 있어요.
visited_pages = {"home", "about", "home"}
print(visited_pages)  # {'home', 'about'}
세트에는 같은 값이 여러 번 들어가지 않습니다. 대신 리스트처럼 순서를 기준으로 꺼내거나 items[0]처럼 위치로 접근할 수는 없어요. 화면에 입력한 순서대로 보여줘야 한다면 세트만으로 처리하지 말고 리스트를 함께 쓰는 방법을 생각해 보세요.
지난 글에서 살펴본 것처럼 세트는 합집합이나 교집합도 간단히 구할 수 있습니다. 두 행사 참가자 중 겹치는 사람을 찾는 일처럼, 중복 제거와 집합 계산이 중심일 때 빛을 발합니다.
고르기 전에 확인할 질문 네 가지
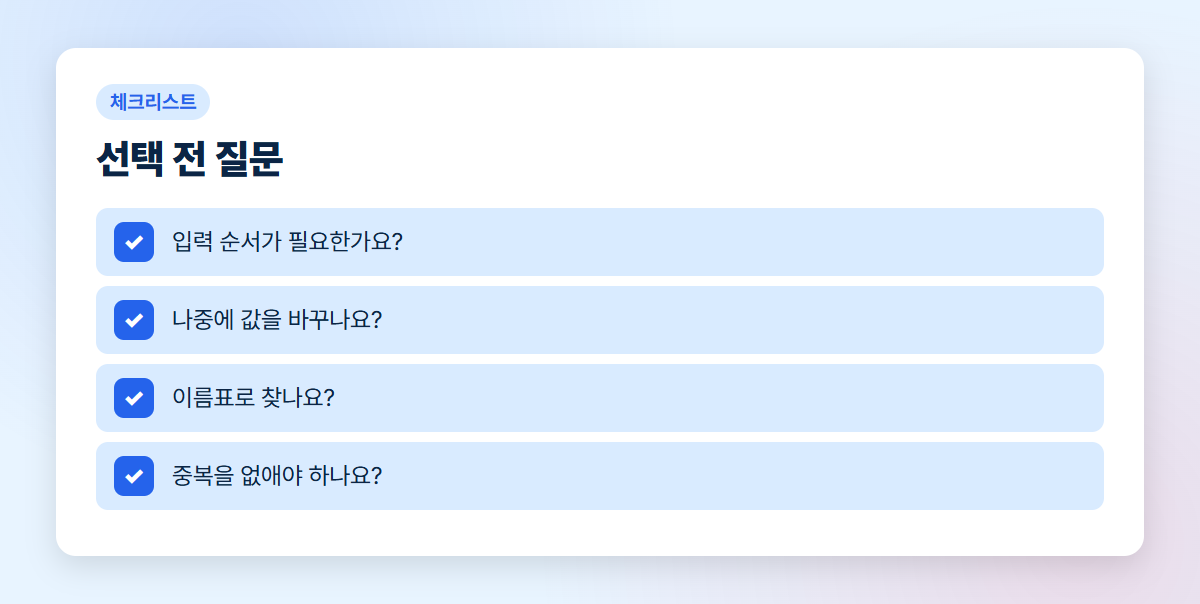
헷갈릴 땐 아래 질문을 차례로 던져 보세요.
- 입력된 순서대로 다룰까? → 리스트나 튜플
- 항목을 나중에 바꿀까? → 리스트
- 이름이나 키로 값을 찾을까? → 딕셔너리
- 중복을 없애거나 포함 여부를 확인할까? → 세트
한 자료 구조가 모든 상황에서 가장 빠르거나 편한 건 아니에요. 데이터가 적을 때는 차이를 체감하지 못할 수도 있고, 어떤 작업을 자주 하느냐에 따라 판단이 달라집니다. 처음부터 복잡한 성능 계산에 빠지기보다는, 데이터의 모양과 사용할 방법을 먼저 보는 게 좋아요.
그리고 필요하면 자료 구조를 섞어도 됩니다. 예를 들어 주문 항목은 리스트로 순서대로 보관하고, 각 주문의 상세 정보는 딕셔너리로 표현할 수 있어요. 도구를 하나만 골라 끝까지 버티는 게 목표는 아니니까요.
작은 예시로 한 번에 정리하기
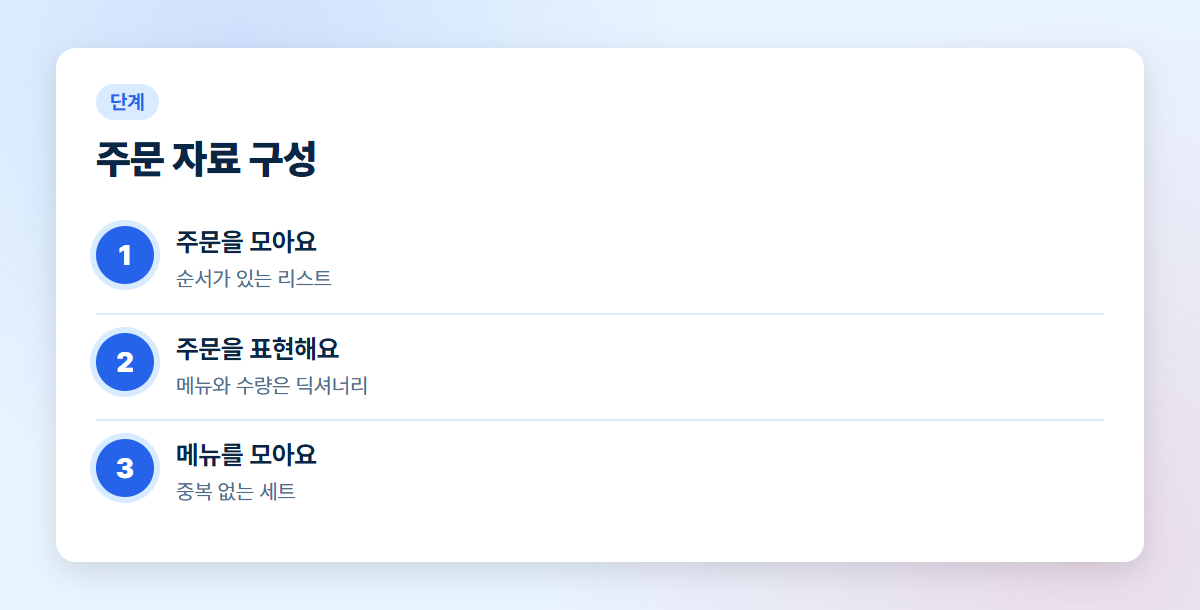
카페 주문 목록을 만든다고 해볼게요. 주문 순서는 리스트로, 주문 하나의 이름과 수량은 딕셔너리로, 메뉴 종류를 중복 없이 모으는 데는 세트를 쓸 수 있습니다.
orders = [
    {"menu": "라떼", "count": 2},
    {"menu": "차", "count": 1},
    {"menu": "라떼", "count": 1},
]

menus = {order["menu"] for order in orders}
print(menus)  # {'라떼', '차'}
이 예시에서는 주문의 순서가 필요하니 리스트를 사용하고, 한 주문의 항목은 이름표로 찾으니 딕셔너리로 묶었어요. 메뉴 이름의 중복을 없애고 싶어서 세트도 더했습니다. 각각 맡은 일이 다르죠.
정리하면, 순서와 수정은 리스트, 바뀌지 않는 묶음은 튜플, 키와 값의 연결은 딕셔너리, 중복 없는 모음은 세트입니다. 이제 자료 구조를 고르는 감이 조금 잡히셨나요? 다음 편에서는 이렇게 모아 둔 데이터를 다루는 동작을 함수로 묶어 보겠습니다. 자주 쓰는 코드를 이름 붙여 재사용하는 방법, 함수 이야기로 넘어가 볼게요.
(html comment removed: aistudio:footer )